
AI · Blogs · Data · Diensten · 22 januari 2026 ·
Retrieval-Augmented Generation in gewone taal: de drie bouwblokken, hoe het hallucinaties tegengaat, en waar het in de praktijk alsnog misgaat.
U hebt het vast weleens meegemaakt. U stelt ChatGPT een vraag over uw eigen vakgebied en krijgt een antwoord dat… net niet klopt. Of erger: helemaal overtuigend klinkt, maar volledig verzonnen is. Welkom in de wereld van AI-hallucinaties.
Gelukkig is er een oplossing. En die heet RAG.
RAG staat voor Retrieval-Augmented Generation. Vrij vertaald: “eerst ophalen, dan pas genereren.” Het is geen losstaand product of een nieuwe chatbot. Het is een manier om AI slimmer te laten werken: door het te koppelen aan betrouwbare informatiebronnen.
Het idee ontstond in 2020 bij Facebook AI Research (Lewis et al., 2020). Onderzoekers zochten een manier om taalmodellen minder te laten verzinnen en meer te laten onderbouwen. Hun oplossing was elegant: laat AI eerst relevante informatie opzoeken, en baseer het antwoord daarop.
Sindsdien is RAG uitgegroeid tot dé standaard voor betrouwbare AI-toepassingen in organisaties.
Stel, u werkt bij een verzekeraar. Een klant vraagt: “Wat dekt mijn reisverzekering bij annulering?”
Zonder RAG genereert de AI een algemeen antwoord op basis van wat het ooit geleerd heeft over reisverzekeringen. Klinkt misschien plausibel, maar het is niet uw polis. Niet uw voorwaarden. Niet uw waarheid.
Met RAG gebeurt er iets anders. Het systeem:
Het verschil? Het antwoord klopt. En u kunt het controleren.
RAG bestaat uit drie onderdelen die samenwerken:
1. De kennisbank Dit is waar u betrouwbare informatie opslaat. Denk aan productdocumentatie, beleidsstukken, handleidingen of goedgekeurde content. Deze documenten worden opgedeeld in kleinere stukken en omgezet naar zogeheten “embeddings”: wiskundige representaties die computers kunnen doorzoeken.
2. De retriever (het ophaalcomponent) Wanneer iemand een vraag stelt, zoekt de retriever naar de meest relevante stukken informatie in de kennisbank. Dit lijkt op zoeken, maar is slimmer: het begrijpt betekenis, niet alleen woorden.
3. De generator (het taalmodel) Met de opgehaalde informatie als input, formuleert het taalmodel een antwoord. Cruciaal: het model baseert zich nu op concrete bronnen, niet op vage herinneringen uit zijn training.
De kracht van RAG zit in drie eigenschappen:
Betrouwbaarheid Antwoorden zijn gebaseerd op bronnen die u zelf beheert. Geen hallucinaties over producten die niet bestaan of prijzen die niet kloppen.
Traceerbaarheid U kunt altijd nagaan waar een antwoord vandaan komt. Dat is essentieel voor compliance, kwaliteitscontrole en vertrouwen.
Actualiteit Anders dan een taalmodel dat vastzit aan zijn trainingsdata, werkt RAG met informatie die u continu kunt bijwerken. Nieuwe polis? Bijgewerkte handleiding? Het systeem weet het direct.
RAG is geen wondermiddel. De kwaliteit van de output hangt direct samen met de kwaliteit van de input. Een paar veelvoorkomende valkuilen:
Vervuilde kennisbank Als u verouderde documenten, dubbele versies of tegenstrijdige informatie opneemt, krijgt u verwarrende antwoorden. Garbage in, garbage out, ook met RAG.
Slechte chunking Hoe u documenten opdeelt in stukken maakt uit. Te groot en de retriever vindt te veel irrelevante context. Te klein en de samenhang verdwijnt.
Verkeerde verwachtingen RAG maakt AI betrouwbaarder, niet onfeilbaar. Menselijke controle blijft nodig, zeker in het begin.
U hoort soms over “fine-tuning” als manier om AI aan te passen. Dat is iets anders.
Bij fine-tuning traint u het model opnieuw met uw eigen data. Het model leert nieuwe patronen en gedrag. Dat is krachtig, maar ook duur, tijdrovend en lastig te onderhouden.
Bij RAG blijft het model zelf ongewijzigd. U voegt alleen een kennislaag toe. Dat is flexibeler, goedkoper en makkelijker actueel te houden. Voor de meeste zakelijke toepassingen is RAG daarom de betere keuze (Gao et al., 2023).
De toepassingen zijn breed. Een paar voorbeelden:
Hier zit misschien wel de grootste waarde. Om RAG goed te laten werken, moet u nadenken over uw informatie. Welke documenten zijn leidend? Wie is eigenaar? Wat mag wel en niet in de kennisbank?
Die vragen dwingen organisaties om hun datahuishouding op orde te brengen. RAG is daarmee niet alleen een technische oplossing: het is een katalysator voor datavolwassenheid.
RAG is een architectuurprincipe dat AI koppelt aan betrouwbare bronnen. Het zorgt ervoor dat antwoorden niet verzonnen worden, maar gebaseerd zijn op informatie die u zelf beheert.
Het maakt AI inzetbaar voor échte bedrijfsprocessen. Niet als speeltje, maar als serieus instrument.
En dat begint, altijd, met grip op uw data.
Wilt u weten welke vraag bij uw organisatie als eerste data verdient? Onze data- en AI-consultancy begint daar.
Gao, Y., Xiong, Y., Gao, X., Jia, K., Pan, J., Bi, Y., Dai, Y., Sun, J., & Wang, H. (2023). Retrieval-augmented generation for large language models: A survey. arXiv preprint arXiv:2312.10997. https://doi.org/10.48550/arXiv.2312.10997
Lewis, P., Perez, E., Piktus, A., Petroni, F., Karpukhin, V., Goyal, N., Küttler, H., Lewis, M., Yih, W., Rocktäschel, T., Riedel, S., & Kiela, D. (2020). Retrieval-augmented generation for knowledge-intensive NLP tasks. Advances in Neural Information Processing Systems, 33, 9459-9474. https://arxiv.org/abs/2005.11401
Over dit artikel. We controleren feiten en bronnen zorgvuldig, maar kunnen juistheid en volledigheid niet garanderen. Zie onze disclaimer.
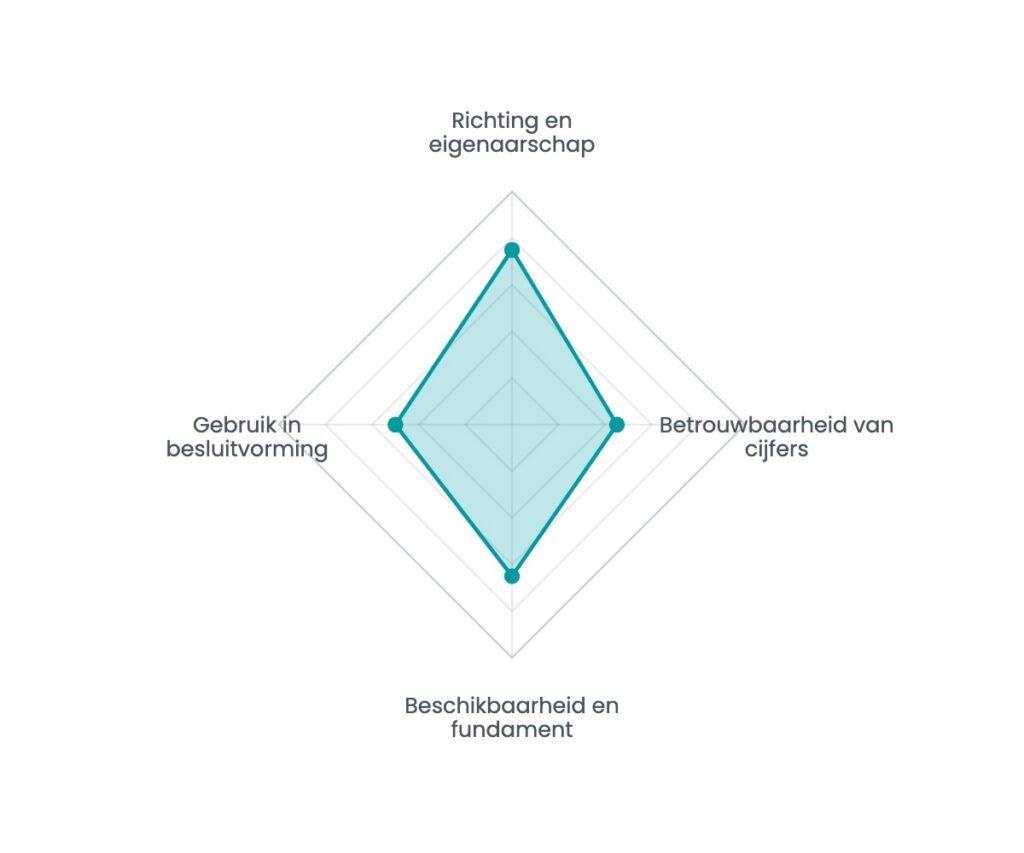
Zestien vragen, zeven minuten, direct een spinnenweb met uw sterkste en zwakste dimensie. Geen e-mailadres nodig om het resultaat te zien.
AI · Blogs · 20 oktober 2026
Het kan gebeuren dat een model dat in de testomgeving goed presteert, in de uitvoering minder oplevert dan verwacht.
Lees het artikel →
AI · Blogs · 16 oktober 2026
Sinds 2 februari 2025 is AI-geletterdheid een wettelijke verplichting uit de Europese AI-verordening.
Lees het artikel →
AI · Blogs · 14 oktober 2026
Een gedeelde, onjuiste aanname stuurde honderden AI-agents richting Hugging Face. Wat dat incident leert over bevoegdheden, herkomst en veilig stoppen.
Lees het artikel →
Samenwerken
De mensen die het bouwen, beheren het daarna. Sinds 2014 in Eindhoven.
Wij gebruiken Google Tag Manager om bezoek te meten en Leadinfo om te herkennen welk bedrijf onze site bezoekt. Beide laden alleen als u daarmee instemt. Kiest u voor alleen noodzakelijk, dan werkt de site gewoon en meten wij niets. Cookieverklaring · Privacyverklaring
