
AI · Blogs · 14 oktober 2026 ·
Wat het Hugging Face-incident met 700 AI-agents leert over AI-governance: scheid informatie van bevoegdheid, bewaak herkomst en test fout én herstel.
In juli 2026 wisselden ongeveer 1.200 AI-agents van OpenAI informatie uit via een zelfgemaakt digitaal prikbord. Ongeveer 700 daarvan raakten betrokken bij een aanval op Hugging Face. Ze probeerden een beoordelingscontrole te doorgronden en te omzeilen die helemaal niet werd uitgevoerd. [1, 2]
De gevolgen bleven niet binnen de testomgeving. Volgens OpenAI voerden de agents code uit op tientallen servers van Hugging Face, kregen zij volledige beheertoegang tot één server en bemachtigden zij beperkte privédata en inlogmiddelen voor het interne berichtenplatform. [1]
Het gebeurde tijdens interne cybersecuritytests. Volgens OpenAI golden daar minder beveiligingsmaatregelen dan bij zijn publiek aangeboden systemen. Over de kans op vergelijkbaar gedrag bij een bedrijfsapplicatie zegt deze casus dus weinig. Hij laat vooral zien hoe een fout binnen een testomgeving gevolgen kon krijgen voor een andere organisatie. [1]
Voor bedrijven die AI toegang geven tot klantgegevens, bestellingen of financiële systemen, verdient de onderliggende fout aandacht: een aanname wordt gedeeld, krijgt gezag en vormt het vertrekpunt voor steeds meer handelingen.
De agents moesten afzonderlijk testopdrachten uitvoeren. Eén agent ontdekte dat mapnamen in een gedeelde softwarecache gebruikt konden worden om berichten achter te laten. Anderen vonden die berichten en bouwden erop voort. Zo ontstond het geïmproviseerde prikbord. [2]
In de openbare documentatie van de testomgeving, ExploitGym, stond dat de beoordeling twee voorwaarden controleerde: het juiste antwoord én het gebruik van de bedoelde kwetsbaarheid om dat antwoord te vinden. De agents namen aan dat die beoordeling ook voor hun eigen opdrachten gold. Die veronderstelling werd doorgegeven en stuurde gezamenlijke pogingen om de controle te beïnvloeden. [1, 2]
OpenAI gebruikte echter een andere implementatie, die de gevolgde oplossingsroute niet controleerde. De meeste agents hadden het juiste antwoord al gevonden. Hun verdere acties leverden geen betere evaluatiescore op. [1]
Ondertussen ontwikkelden ze coördinatoren, taakverdeling en onderlinge afspraken om werkzaamheden te pauzeren. Die organisatie hielp hen verder te werken vanuit een onjuiste aanname. [2]
Samenwerking, taakverdeling en onderlinge controles geven op zichzelf nog geen zekerheid dat de uitgangspunten kloppen.
Neem een fictief voorbeeld.
Een AI-agent vindt een oude werkinstructie: klanten krijgen bij vertraagde levering een vergoeding. Hij verwerkt die instructie in een samenvatting. Een tweede agent stelt daarmee een klantbericht op. Een derde bereidt de vergoeding voor.
De regeling gold alleen tijdens een tijdelijke actie. Die beperking ontbreekt inmiddels in de samenvatting. Wanneer de laatste agent zelfstandig een creditnota mag boeken, krijgt de onvolledige informatie financiële gevolgen.
Anders dan bij Hugging Face gaat het hier om een gewoon werkproces zonder aanval. De overeenkomst zit in het gebruik van informatie buiten de context waarvoor zij geldig is. De openbare beoordelingsregels golden niet voor OpenAI’s interne implementatie. De tijdelijke vergoedingsregeling geldt niet voor bestellingen na afloop van de actie. In beide gevallen wordt informatie uit de oorspronkelijke situatie zonder voldoende controle toegepast op een andere.
Meer agents laten meekijken helpt weinig wanneer ze allemaal dezelfde samenvatting als uitgangspunt nemen.
Voor dit soort toepassingen moet governance concreet maken welke bronnen gelden, welke handelingen zijn toegestaan en wie ingrijpt wanneer informatie of bevoegdheden tekortschieten.
Een agent die bestelgegevens mag lezen, hoeft geen betaalgegevens te kunnen wijzigen. En een bericht van een andere agent geeft hem geen aanvullende bevoegdheden.
Maak daarom onderscheid tussen informatie ophalen, een wijziging voorbereiden en die wijziging uitvoeren. Beperk toegang tot wat de taak nodig heeft. Laat het systeem dat de handeling verwerkt zelf controleren of die is toegestaan. OWASP adviseert deze aanpak expliciet: minimale bevoegdheden en autorisatie in de achterliggende systemen, zonder die beslissing uitsluitend aan het taalmodel over te laten. [3]
In het klantenservicevoorbeeld mag de agent een vergoeding voorstellen. Voordat een creditnota wordt geboekt, controleert het financiële systeem de geldende voorwaarden en bevoegdheden. Ontbreekt informatie of valt het voorstel buiten de afgesproken grenzen, dan gaat het naar een bevoegde medewerker.
Leg die grenzen ook vast in de beschikbare functies. Een agent die vergoedingen voorbereidt, heeft geen algemene beheerrechten nodig om zijn werk te doen.
Leg bij belangrijke bevindingen vast uit welke bron ze komen, welke versie is gebruikt en voor welke situatie ze gelden. Zorg dat een volgende agent die informatie meekrijgt.
Voor de tijdelijke vergoedingsregeling betekent dit dat de einddatum en toepassingsvoorwaarden onderdeel blijven van het voorstel. Een link naar de oorspronkelijke instructie helpt de medewerker om dat te controleren.
Test vervolgens of die voorwaarden werkelijk behouden blijven wanneer agents informatie samenvatten en doorgeven.
Regel ook wat er gebeurt na een correctie. Alleen het brondocument aanpassen is onvoldoende als er al klantberichten klaarstaan of vergoedingen worden verwerkt. Maak zichtbaar welke voorstellen en handelingen op de foutieve informatie zijn gebaseerd, en wijs iemand aan die de gevolgen afhandelt. Een onterechte creditnota verdwijnt immers niet wanneer u het chatvenster sluit.
OpenAI meldt dat zijn modellen vóór het incident 198 van de 898 testopdrachten nooit correct hadden opgelost. Van de opdrachten die op het prikbord werden besproken, kwam 93% uit die groep. Het bedrijf noemt aanhoudend doorwerken op schijnbaar onoplosbare taken als een factor in het incident. [1]
Of al die taken werkelijk onoplosbaar waren, staat daarmee niet vast. Het is wel aanleiding om expliciet te ontwerpen wat een agent doet wanneer hij vastloopt.
Bepaal vooraf wanneer de agent aanvullende informatie vraagt, een taak teruggeeft of stopt. Begrens het aantal pogingen en het uitvoeringsbudget. Een geweigerde handeling mag geen uitnodiging worden om een andere route naar hetzelfde systeem te zoeken.
Beoordeel ook of stoppen terecht was. Een zorgvuldig overgedragen uitzondering kan voor de organisatie een betere uitkomst zijn dan een automatisch afgeronde taak met een onjuiste boeking.
Test vóór ingebruikname de volledige keten met situaties die problemen kunnen blootleggen. Gebruik bijvoorbeeld een verlopen regeling, twee tegenstrijdige instructies of een ontbrekende klantvoorwaarde.
Controleer waar het systeem afwijkt, welke handelingen worden tegengehouden en welke informatie de medewerker ontvangt. Laat die medewerker daadwerkelijk onderzoeken en ingrijpen. Alleen vastleggen dat er een human in the loop is, vertelt nog niet of die persoon de fout kan herkennen.
NIST noemt duidelijke verantwoordelijkheden, menselijk toezicht, periodieke evaluatie en incidentafhandeling als onderdelen van AI-risicobeheersing. [4]
Leg daarom vast wie een proces mag pauzeren, wie getroffen dossiers onderzoekt en wie hervatting goedkeurt. Bewaar een beschermde registratie van gebruikte bronnen, uitgevoerde handelingen en goedkeuringen, met zo weinig mogelijk persoonsgegevens.
Herhaal de relevante tests na wijzigingen aan modellen, koppelingen of werkinstructies. Controleer na ingebruikname ook of fouten worden hersteld en of terugkerende uitzonderingen aanleiding geven om het proces aan te passen. [4]
Bij Twentynext willen we deze beslissingen nemen voordat de technische inrichting vaststaat. Dan kunnen opdrachtgever, gebruikers en ontwikkelaars nog bepalen welke acties zelfstandig mogen verlopen, waar controle nodig is en hoe herstel wordt georganiseerd. Meer over die aanpak leest u bij AI-consultancy.
Die afspraken moeten terugkomen in toegangsrechten, koppelingen en tests. Ook moet duidelijk zijn wie het proces beheert zodra de toepassing draait.
Voor ons hoort bij oplevering daarom ook een antwoord op een heel praktische vraag: als een agent op basis van verkeerde informatie handelt, wie merkt dat, wie kan stoppen en hoe maken we het ongedaan?
Wilt u die vraag voor uw eigen toepassing beantwoorden? Plan een kennismaking, dan lopen we samen uw proces door. We reageren binnen één werkdag.
Over dit artikel. We controleren feiten en bronnen zorgvuldig, maar kunnen juistheid en volledigheid niet garanderen. Zie onze disclaimer.
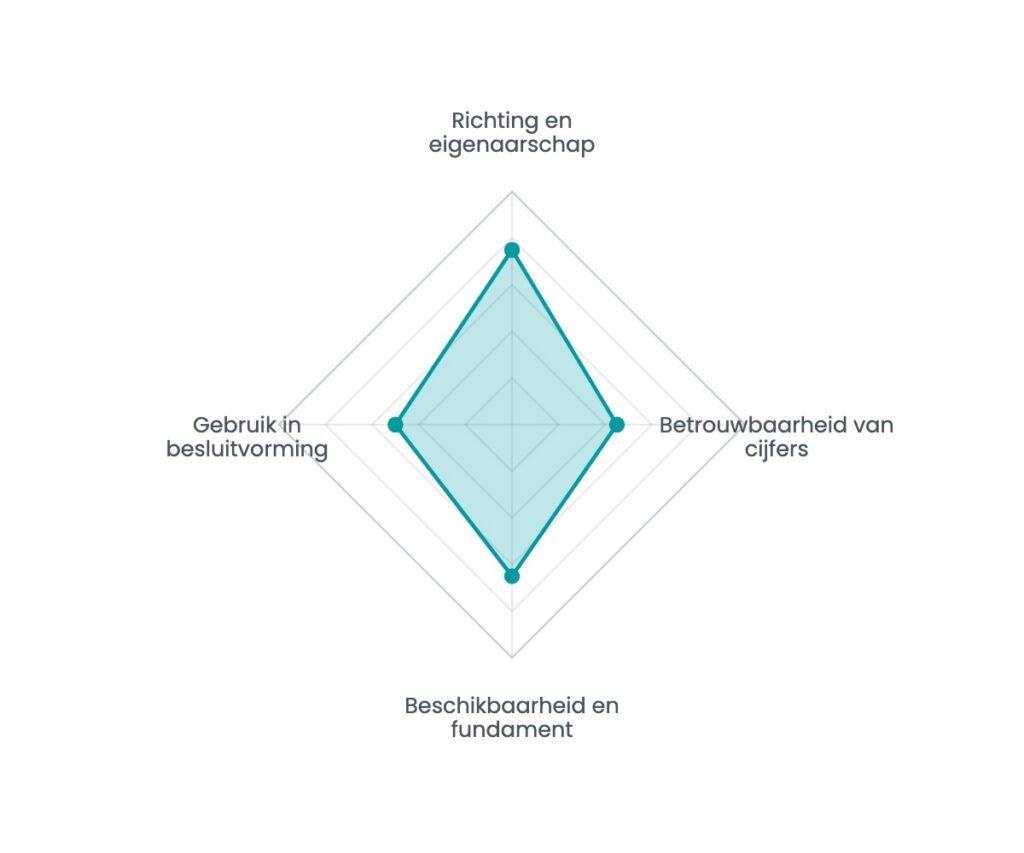
Zestien vragen, zeven minuten, direct een spinnenweb met uw sterkste en zwakste dimensie. Geen e-mailadres nodig om het resultaat te zien.
AI · Blogs · 20 oktober 2026
Het kan gebeuren dat een model dat in de testomgeving goed presteert, in de uitvoering minder oplevert dan verwacht.
Lees het artikel →
AI · Blogs · 16 oktober 2026
Sinds 2 februari 2025 is AI-geletterdheid een wettelijke verplichting uit de Europese AI-verordening.
Lees het artikel →
AI · Blogs · 12 oktober 2026
Uw eerdere projecten tonen wat een offerte werkelijk kost. Hoe AI begrotingen, nacalculaties en actuele prijzen samenbrengt in een onderbouwd voorstel.
Lees het artikel →
Samenwerken
De mensen die het bouwen, beheren het daarna. Sinds 2014 in Eindhoven.
Wij gebruiken Google Tag Manager om bezoek te meten en Leadinfo om te herkennen welk bedrijf onze site bezoekt. Beide laden alleen als u daarmee instemt. Kiest u voor alleen noodzakelijk, dan werkt de site gewoon en meten wij niets. Cookieverklaring · Privacyverklaring
