
Blogs · Data · 21 september 2026 ·
Uitbreidingen op CRISP-DM die de stappen concreter maken, vier op een rij: IBM’s tien stappen, TDSP, CRISP-ML(Q) en CASP-DM, en waar Twentynext mee werkt.
Gemaakt met AI. Nagelezen door een tweede AI-model. Zie onze disclaimer.
Die zijn er, en Twentynext werkt zelf met één ervan: de tien stappen van IBM’s Foundational Methodology for Data Science. CRISP-DM 1.0 uit 2000 beschrijft een dataproject als een cyclus van zes fasen, maar laat bewust open hoe u die fasen invult: welke rollen erbij horen, hoe kwaliteit geborgd wordt en wat er na de livegang gebeurt. Sindsdien zijn er verschillende uitbreidingen verschenen die precies die gaten vullen. Hieronder staan de vier die wij in de praktijk tegenkomen, met een zijstap naar een vijfde, wie ze beschrijft, en wat wij ermee doen.
De oorspronkelijke methodiek, ontwikkeld door een consortium van NCR, SPSS, Daimler-Benz en OHRA, is sterk in de volgorde: eerst de bedrijfsvraag, dan de data, dan pas het model, en een evaluatie vóór de uitrol. Wat ze dun beschrijft is de fase Deployment, en wat ze helemaal niet beschrijft is de periode daarna: monitoring, hertrainen, eigenaarschap. Ook de stap vóór de dataverkenning ontbreekt als eigen fase: welke soort analyse past bij de vraag, en welke data heeft die nodig? In onze projecten blijken juist die stappen te bepalen of een project iets oplevert.
De uitbreiding waar Twentynext mee werkt. John Rollins beschreef in 2015 voor IBM Analytics een methodiek die de zes fasen van CRISP-DM behoudt en er vier stappen aan toevoegt die in CRISP-DM binnen bestaande fasen verstopt zitten: Analytic Approach (welke soort analyse past bij de vraag: voorspellen, verklaren, signaleren of optimaliseren), Data Requirements (welke data die analyse nodig heeft), Data Collection (hoe die data binnenkomt en wat er ontbreekt) en Feedback (wat er na de livegang met de uitkomsten gebeurt). De teruglussen horen erbij: blijkt tijdens het verzamelen dat de eisen niet kloppen, dan gaan ze terug naar Data Requirements; blijkt na de livegang dat de werkelijkheid onder het model verschuift, dan gaat dat terug naar Modeling. Het maakt de stappen concreter zonder de methodiek zwaarder te maken. IBM publiceerde in dezelfde periode ook ASUM-DM, een uitgebreidere variant met projectmanagement en infrastructuur erbij, die vooral in grote programma’s wordt gebruikt.
Microsofts Team Data Science Process (TDSP) is verwant aan CRISP-DM en legt vooral vast wat een team nodig heeft om zo’n proces samen uit te voeren: een standaard projectstructuur, rolverdeling (projectleider, data scientist, engineer), sjablonen voor de tussenproducten per fase en een aanbevolen infrastructuur. De methodiek is gedocumenteerd op Microsoft Learn en bruikbaar los van Azure. Voor organisaties die meerdere dataprojecten naast elkaar draaien, is dit de uitbreiding die de meeste herhaalbaarheid oplevert.
Studer en collega’s publiceerden in 2021 CRISP-ML(Q), een procesmodel voor machine learning met een kwaliteitsborgingsmethodiek per fase. De belangrijkste toevoegingen: per fase een expliciete risico-inventarisatie met bijbehorende maatregelen, en een eigen fase Monitoring and Maintenance die het onderhoud van een model in productie als volwaardig onderdeel van het proces beschrijft. Wie CRISP-DM te weinig vindt zeggen over wat er na de uitrol gebeurt, vindt hier de meest uitgewerkte aanvulling.
Martínez-Plumed en collega’s stelden in 2017 CASP-DM voor, Context Aware Standard Process for Data Mining. De kern: een model wordt getraind in één context (een periode, een vestiging, een klantgroep) en daarna gebruikt in een andere. CASP-DM voegt aan elke fase de vraag toe welke aannames contextgebonden zijn en wat er moet gebeuren als de context verandert. Dat is minder een methodiek voor het eerste project dan voor het tweede: wanneer u een werkend model wilt hergebruiken op een andere afdeling of een ander jaar.
Wij volgen voor de datawetenschappelijke kern van onze projecten de tien stappen van IBM’s methodiek. Twee dingen voegen we daar zelf aan toe. Bij elk project spreken we vooraf één meetpunt af waarop u ons mag afrekenen, in termen van een beslissing die anders gaat, niet in termen van modelnauwkeurigheid. En de fase Deployment is bij ons geen overdracht aan een andere partij: wat wij bouwen, houdt onze dienst Service & Beheer daarna draaiend, inclusief de stap Feedback. Hoe de tien stappen er per fase uitzien, staat op onze pagina over CRISP-DM.
Wilt u weten welke methodiek bij uw project past? Plan een kennismaking van 30 minuten; we reageren binnen één werkdag. Eerst weten waar uw organisatie staat met data? Doe de gratis Data Maturity Scan: zestien vragen, direct resultaat.
Chapman, P., Clinton, J., Kerber, R., Khabaza, T., Reinartz, T., Shearer, C. & Wirth, R. (2000). CRISP-DM 1.0: Step-by-step data mining guide. SPSS Inc.
Rollins, J. B. (2015). Foundational Methodology for Data Science. IBM Analytics.
Microsoft. (2026). What is the Team Data Science Process? Microsoft Learn. https://learn.microsoft.com/en-us/azure/architecture/data-science-process/overview
Studer, S., Bui, T. B., Drescher, C., Hanuschkin, A., Winkler, L., Peters, S. & Müller, K.-R. (2021). Towards CRISP-ML(Q): A machine learning process model with quality assurance methodology. Machine Learning and Knowledge Extraction, 3(2), 392–413. https://arxiv.org/abs/2003.05155
Martínez-Plumed, F., Contreras-Ochando, L., Ferri, C., Flach, P., Hernández-Orallo, J., Kull, M., Lachiche, N. & Ramírez-Quintana, M. J. (2017). CASP-DM: Context Aware Standard Process for Data Mining. arXiv. https://arxiv.org/abs/1709.09003
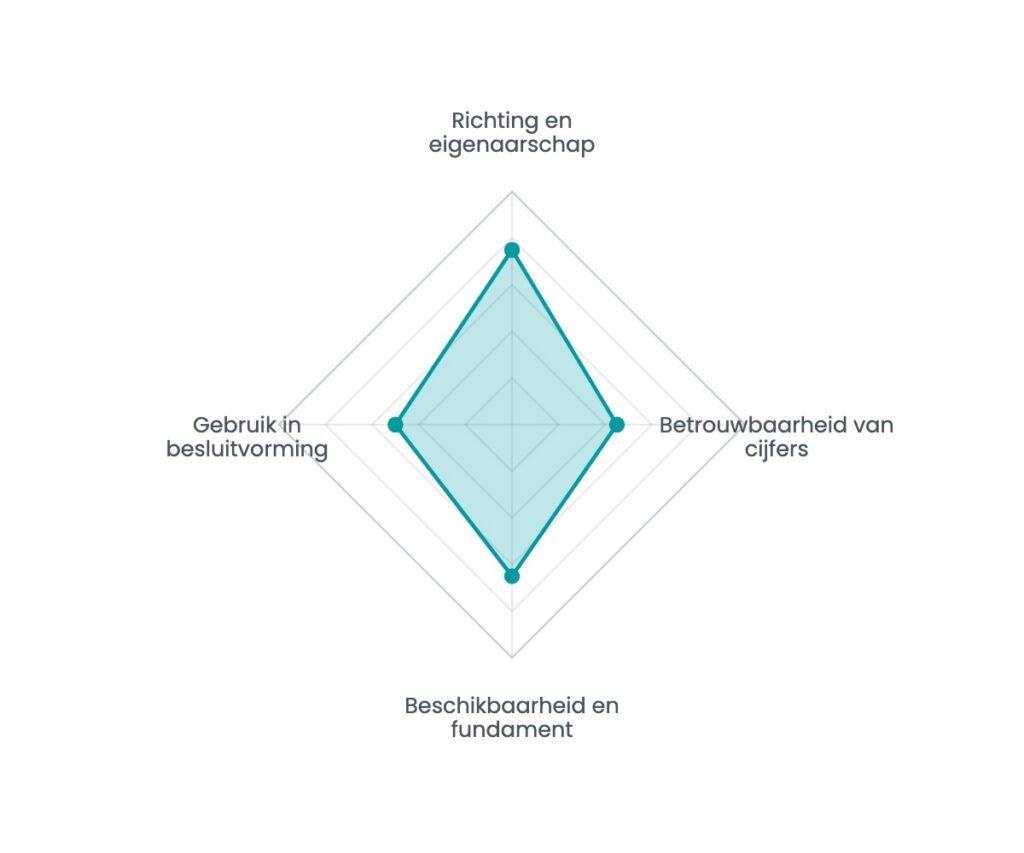
Zestien vragen, zeven minuten, direct een spinnenweb met uw sterkste en zwakste dimensie. Geen e-mailadres nodig om het resultaat te zien.
AI · Blogs · 5 november 2026
De business case voor een AI-toepassing ziet er op papier vaak overzichtelijk uit: licenties, een model, ontwikkeluren en een pilot van drie maanden.
Lees het artikel →
Blogs · 5 november 2026
Wie zoekt naar een bureau voor een AI-dataplatform, ziet websites die sterk op elkaar lijken.
Lees het artikel →
AI · Blogs · 20 oktober 2026
Het kan gebeuren dat een model dat in de testomgeving goed presteert, in de uitvoering minder oplevert dan verwacht.
Lees het artikel →
Samenwerken
De mensen die het bouwen, beheren het daarna. Sinds 2014 in Eindhoven.
Wij gebruiken Google Tag Manager om bezoek te meten en Leadinfo om te herkennen welk bedrijf onze site bezoekt. Beide laden alleen als u daarmee instemt. Kiest u voor alleen noodzakelijk, dan werkt de site gewoon en meten wij niets. Cookieverklaring · Privacyverklaring
