
AI · Blogs · 5 november 2026 ·
De business case voor een AI-toepassing ziet er op papier vaak overzichtelijk uit: licenties, een model, ontwikkeluren en een pilot van drie maanden. Stel dat het team een half jaar later nog aan de inputkant zit. Velden blijken anders gevuld dan gedacht, twee systemen hanteren een ander klantnummer en niemand weet wie de bron beheert.
Zulke kosten staan niet altijd in de begroting, en ze kunnen meebepalen of een project rendeert. Hieronder leest u waar ze vandaan komen, welke architectuurkeuzes ze veroorzaken en hoe u ze vooraf zichtbaar maakt in plaats van achteraf te ontdekken.
In een begroting kan de post “AI” vooral het model, de tooling en het team dat het bouwt omvatten. Het werk eromheen, zoals data vinden, begrijpen, corrigeren, koppelen en in de lucht houden, kan dan buiten beeld raken.
ITS Value schat in dat verborgen kosten voor data en infrastructuur de zichtbare kosten van AI gemakkelijk kunnen verdubbelen of verdrievoudigen. Dat is een inschatting van die bron en geen algemene verwachting voor elk project. Stratalytic rekende vijf MKB-trajecten door en komt voor die trajecten op 10.000 tot 60.000 euro per project, met complexiteit en datakwaliteit als bepalende factoren (per november 2026). Dat zijn uitkomsten van die doorrekening en geen representatieve cijfers voor Nederlandse organisaties; hoe de trajecten zijn afgebakend, leest u in de bron zelf.
Dat laatste is de kern: datakwaliteit staat in zo’n doorrekening als kostenfactor naast complexiteit. Loopt een project vast, dan loont het om eerst naar de datakant te kijken voordat het model ter discussie staat. Tijd kan opgaan aan uitzoeken waarom twee rapportages een ander totaal geven, en wie daar iets over mag beslissen.
Slechte data kan een oorzaak in de architectuur hebben. Wie de oorzaak zoekt, kan bijvoorbeeld nagaan of er kopieën van datasets zonder eigenaar bestaan, of definities per afdeling verschillen, of invoer wordt gevalideerd en of integraties ooit als eenmalige export zijn gebouwd.
Een AI-project kan die zwakke plekken zichtbaar maken. Een medewerker die een rapport leest, kan een afwijkend veld soms zelf herkennen. Bij een model hangt dat af van de toepassing en de controles die eromheen zijn ingericht.
Een voor de hand liggende route is per project opschonen. Ga in dat geval na of de correctie ook in de bron wordt doorgevoerd. Datakingdom beschrijft een verwant probleem: zonder betrouwbare en goed gestructureerde data blijven AI-projecten steken in de experimenteerfase.
Eltjo Poort van CGI schrijft dat architectuur haar waarde ontleent aan beslissingen die kostbaar, ingrijpend of riskant zijn om later terug te draaien. Bij AI-projecten kunnen die beslissingen impliciet worden genomen, door het eerste team dat iets werkends nodig heeft.
Beslissingen die het waard zijn om vooraf expliciet te nemen:
Naast de technische uitwerking vragen deze punten afspraken tussen teams die elkaar in de lijn zelden tegenkomen.
Radu Vunvulea beschrijft waarom AI-ROI vluchtiger is dan die van klassieke IT-projecten, onder meer omdat de kosten kunnen meestijgen met het gebruik.
Een wijziging in een bronsysteem, zoals een nieuw veld, een gewijzigde codetabel of een migratie, kan de keten verstoren. Bepaal daarom vooraf hoe u zo’n breuk opmerkt, bijvoorbeeld met monitoring op datakwaliteit of andere controles.
Een enquête van Jitterbit uit augustus 2026 meldt dat 78 procent van de AI-projecten nu al meerwaarde oplevert. Dat is een uitkomst van die enquête en geen representatief cijfer voor Nederlandse organisaties. Wat de enquête onder “AI-projecten” en “meerwaarde” verstaat, leest u in de bron zelf; zonder die afbakening is het percentage lastig te duiden. Voor de marge tellen ook de kosten van het onderhouden van de datatoevoer mee.
De eerlijke conclusie: de ROI van een AI-toepassing is pas te beoordelen als de doorlopende datakosten erin zitten. Een pilot die dat buiten beeld laat, kan een te rooskleurig beeld geven.
Een aantal maatregelen die helpen om een begroting halverwege niet te hoeven herzien.
Neem een aparte regel “data” op in de business case, gesplitst in eenmalig (ontsluiten, opschonen, koppelen) en doorlopend (beheer, monitoring, aanpassingen bij bronwijzigingen). Twee scenario’s naast elkaar, een optimistisch en een realistisch, dwingen tot het gesprek dat u anders pas later voert.
Doe voor elke use case een korte datareadiness-toets voordat u ontwikkelcapaciteit vastlegt. Welke bronnen, wie is eigenaar, hoe vers is de data, welke kwaliteitsproblemen zijn al bekend. Zo’n toets kan helpen om problemen die bij de proceseigenaar al bekend zijn op tafel te krijgen voordat het team eraan begint.
Weeg bij de eerste use cases af of een gedeelde ontsluitingslaag of losse koppelingen beter past. Vragen die daarbij helpen: hoeveel toepassingen hebben dezelfde bronnen nodig, en wie beheert de koppelingen als het er meer worden?
Leg eigenaarschap vast voordat het project start. Dat hoeft geen fulltime functie te zijn, maar het moet wel iemands taak zijn om over definities en kwaliteit te beslissen.
Wees realistisch over doorlooptijden. Kies een smal pad: de paar bronnen die deze ene toepassing nodig heeft, goed ontsloten en met een eigenaar, en breid vanaf daar uit.
Pak één AI-toepassing die u gepland heeft of die al loopt. Zet op een A4 alle databronnen die ze nodig heeft, en noteer per bron vier dingen: het bronsysteem, de eigenaar, de verversingsfrequentie en de bekende kwaliteitsproblemen.
Dat invullen doet u het best samen met de proceseigenaar en een data engineer. De lege vakjes op dat A4 wijzen op mogelijke kosten of risico’s.
Met die lijst in de hand kunt u een gefundeerde keuze maken: oplossen binnen het project, of structureel regelen omdat de volgende use case dezelfde bronnen nodig heeft. Beide zijn verdedigbaar. Niet kiezen is de dure optie.
Zo maken we dit. AI schrijft de eerste versie, een tweede AI-model van een andere aanbieder controleert hem, en een mens van Twentynext heeft dit artikel gelezen en goedgekeurd voordat het live ging. We controleren feiten en bronnen zorgvuldig, maar kunnen juistheid en volledigheid niet garanderen. Zie onze disclaimer.
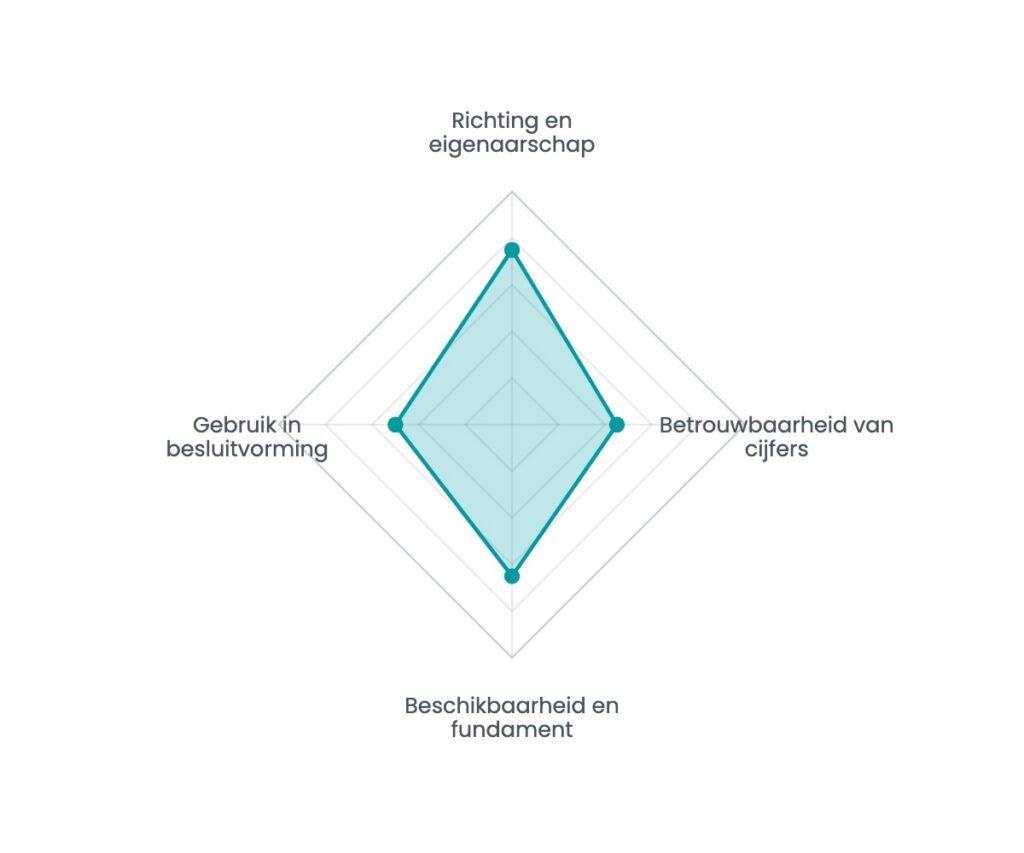
Zestien vragen, zeven minuten, direct een spinnenweb met uw sterkste en zwakste dimensie. Geen e-mailadres nodig om het resultaat te zien.
Blogs · 5 november 2026
Wie zoekt naar een bureau voor een AI-dataplatform, ziet websites die sterk op elkaar lijken.
Lees het artikel →
AI · Blogs · 20 oktober 2026
Het kan gebeuren dat een model dat in de testomgeving goed presteert, in de uitvoering minder oplevert dan verwacht.
Lees het artikel →
AI · Blogs · 16 oktober 2026
Sinds 2 februari 2025 is AI-geletterdheid een wettelijke verplichting uit de Europese AI-verordening.
Lees het artikel →
Samenwerken
De mensen die het bouwen, beheren het daarna. Sinds 2014 in Eindhoven.
Wij gebruiken Google Tag Manager om bezoek te meten en Leadinfo om te herkennen welk bedrijf onze site bezoekt. Beide laden alleen als u daarmee instemt. Kiest u voor alleen noodzakelijk, dan werkt de site gewoon en meten wij niets. Cookieverklaring · Privacyverklaring
