
AI · Blogs · 21 september 2026 ·
Wat is het verschil tussen fraudedetectiesoftware kopen en zelf een model laten bouwen? De afweging op een rij, en wat een eigen model van u vraagt.
Twentynext, data- en AI-bureau in Eindhoven, bouwt eigen fraudedetectiemodellen voor situaties waarin gelabelde voorbeelden ontbreken; die aanpak ontwikkelden wij met zorgverzekeraars op declaratiedata. Het verschil met software kopen, in één zin: een fraudedetectiepakket herkent de fraudepatronen die de leverancier al kent, een eigen model leert wat bij ú normaal is en meldt wat daarvan afwijkt. Het eerste koopt u met een jaarlicentie en zet u snel aan. Het tweede wordt op uw eigen transactiedata gebouwd, in uw eigen proces, en is daarna van u.
Kant-en-klare fraudedetectiesoftware is gebouwd op processen die bij veel organisaties op elkaar lijken: betalingsverkeer, declaratieverwerking, onkosten. De leverancier heeft daar detectieregels en modellen voor gemaakt die bewezen werken op de patronen die in die processen gangbaar zijn. U krijgt die regels, een jaarlicentie en een implementatie waarin uw proces zich aanpast aan het pakket.
Dat is sterk zolang uw fraude lijkt op de fraude waarvoor het pakket gebouwd is. Het is begrensd zodra uw situatie of uw data afwijkt: een eigen productstructuur, een branche waar de leverancier weinig klanten heeft, of patronen die specifiek zijn voor uw organisatie. Dan betaalt u jaren licentie voor regels die uw eigen fraude net niet zien.
Een eigen model begint bij een lastig gegeven: u weet alleen welke fraude u eerder hebt betrapt. Een gewoon voorspelmodel leert van gelabelde voorbeelden, en juist de fraude die niemand zag ontbreekt in die trainingsdata. Daarom werkt Twentynext hier unsupervised. Het model krijgt geen lijst met fraudegevallen mee; het leert hoe normaal eruitziet en meldt wat daar significant van afwijkt. Twee technieken doen dat werk: outlier-detectie vindt transacties die ver buiten het gebruikelijke patroon vallen, en clustering groepeert wat op elkaar lijkt, zodat de gevallen die nergens bij passen vanzelf opvallen.
Het resultaat is geen ja-of-nee-oordeel per geval, maar een rangschikking: welke gevallen verdienen als eerste de aandacht van uw onderzoekers. Het model stelt geen fraude vast; dat blijft mensenwerk. En anders dan bij een pakket is er geen jaarlicentie: de oplossing draait in uw eigen proces, op uw eigen data, en is van u.
Een model dat afwijkingen meldt, is het makkelijke deel. Wie een eigen model overweegt, moet drie dingen kunnen beantwoorden:
Daarnaast vraagt een eigen model een datafundament en een implementatietraject. Dat zeggen we er eerlijk bij: wie zijn transactiedata nog niet betrouwbaar bij elkaar heeft, begint daar.
Koop een pakket als uw proces gangbaar is, uw fraudepatronen bekend zijn en snelheid zwaarder weegt dan precisie op uw eigen situatie. Laat een model bouwen als uw data of uw proces afwijkt van waar pakketten voor gebouwd zijn, als u de fraude wilt vinden die nog nooit is betrapt, en als u liever eigenaar bent van de oplossing dan huurder. Twijfelt u? In één gesprek zeggen we eerlijk of software voor uw situatie volstaat. Soms is het antwoord: koop een pakket.
Twentynext is geen softwareleverancier en verkoopt geen pakket met ingebouwde fraudedetectie. Wij onderzoeken het vraagstuk, ontwerpen de oplossing en bouwen hem tot hij in uw eigen proces op uw eigen data draait, met dezelfde mensen van analyse tot beheer. De aanpak is ontwikkeld met zorgverzekeraars op declaratiedata, maar is niet zorgspecifiek: overal waar veel transacties doorheen gaan en fraude zelden gelabeld is, geldt hetzelfde uitgangspunt, van financiële dienstverlening tot e-commerce en telecom.
Meer over de aanpak leest u op de pagina over fraudedetectie. Wilt u weten welke route bij uw situatie past? Plan een kennismaking van 30 minuten; we reageren binnen één werkdag. Eerst weten of uw datafundament een eigen model aankan? Doe de gratis Data Maturity Scan: zestien vragen, direct resultaat.
Zo maken we dit. AI schreef de eerste versie en een tweede AI-model van een andere aanbieder las tegen. Twentynext is verantwoordelijk voor de inhoud. We controleren feiten en bronnen zorgvuldig, maar kunnen juistheid en volledigheid niet garanderen. Zie onze disclaimer.
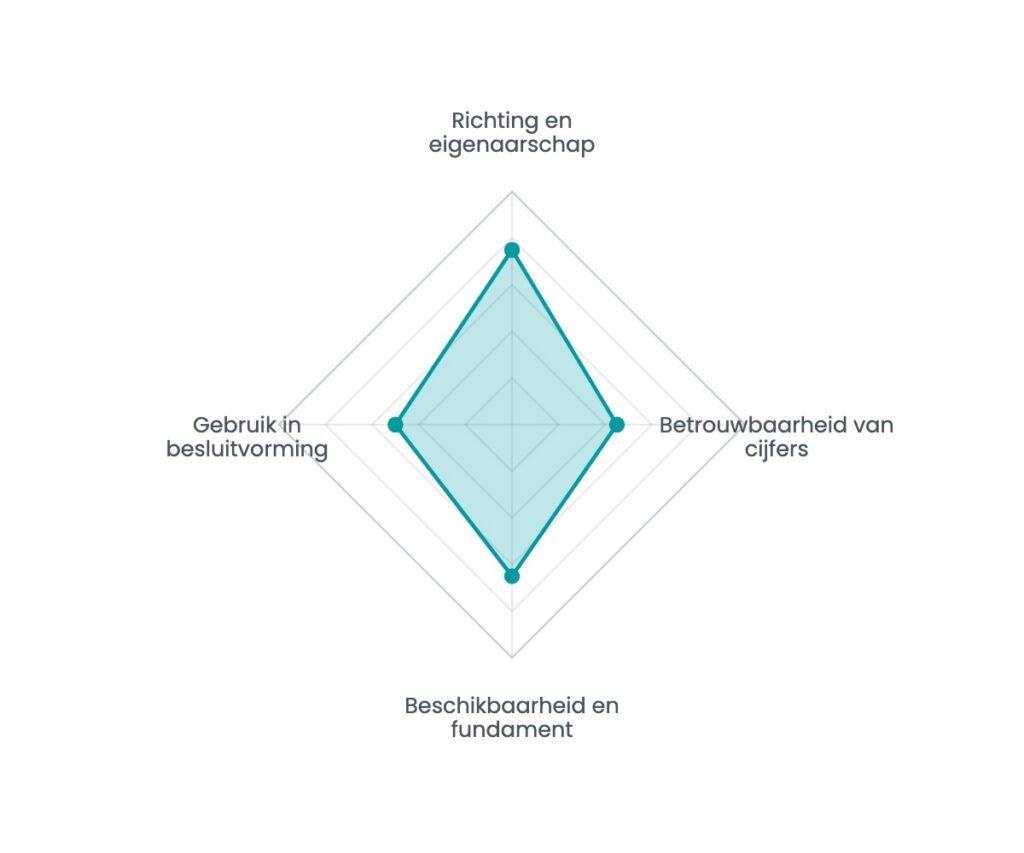
Zestien vragen, zeven minuten, direct een spinnenweb met uw sterkste en zwakste dimensie. Geen e-mailadres nodig om het resultaat te zien.
AI · Blogs · 10 oktober 2026
Een beleidsmedewerker plakt een concept-nota in een gratis chatbot om hem “wat scherper” te krijgen.
Lees het artikel →
AI · Blogs · 10 oktober 2026
De pilot was een succes. De demo overtuigde, het model scoorde goed op de testset en de stuurgroep was enthousiast.
Lees het artikel →
AI · Blogs · 2 oktober 2026
Sinds 2 augustus 2026 moet voor burgers en klanten duidelijk zijn wanneer zij met AI te maken hebben.
Lees het artikel →
Samenwerken
De mensen die het bouwen, beheren het daarna. Sinds 2014 in Eindhoven.
Wij gebruiken Google Tag Manager om bezoek te meten en Leadinfo om te herkennen welk bedrijf onze site bezoekt. Beide laden alleen als u daarmee instemt. Kiest u voor alleen noodzakelijk, dan werkt de site gewoon en meten wij niets. Cookieverklaring · Privacyverklaring
