
Blogs · Data · 24 september 2026 ·
Wat een scan van uw data-architectuur onderzoekt, wie u aan tafel zet, wat het concreet oplevert en waar zo’n scan vaak misgaat. Voordat u met AI begint.
Het bestuur wil met AI aan de slag, de controller vertrouwt de maandrapportage niet en de enige collega die weet hoe de koppeling met het ERP-systeem werkt, gaat over een half jaar met pensioen. Drie problemen die op het eerste gezicht los van elkaar staan, maar die alle drie lastig aan te pakken zijn zolang niemand een actueel beeld heeft van hoe de data in uw organisatie stroomt.
Een scan van uw data-architectuur maakt dat beeld. Hieronder leest u wat een goede scan onderzoekt, wie u daarbij nodig hebt, wat het concreet oplevert en waar zo’n scan vaak de mist ingaat. En ook wat u er níet van mag verwachten.
Een scan zoals wij die bedoelen is een gestructureerde opname van de huidige situatie. Welke systemen staan er, welke koppelingen lopen ertussen, wie is eigenaar van welke gegevens en waar botsen definities.
In die afbakening is het geen ontwerp van de nieuwe situatie. Dat komt daarna, en pas als u weet waar u staat. Het is ook geen toolselectie. Eindigt een scan in een aanbeveling voor een specifiek platform, dan is het de vraag of uw huidige situatie of het aanbod van de uitvoerder het uitgangspunt was.
Het is evenmin in de eerste plaats een audit met een cijfer. Een score of volwassenheidsniveau kan helpen om de urgentie zichtbaar te maken, maar het bruikbare deel zit in de bevindingen: waar zit het risico, wat blokkeert uw plannen en wat kunt u als eerste aanpakken.
Niet elke organisatie heeft op elk moment een scan nodig. In onze ervaring zijn er een aantal momenten waarop het loont om eerst de huidige situatie in kaart te brengen:
Herkent u een of meer van deze situaties, dan is het de vraag hoeveel u eigenlijk weet over de basis waarop u verder bouwt. Een AI-project kan dan vastlopen op datakwaliteit of ontbrekend eigenaarschap, en het risico is dat u dat pas ontdekt als er al veel werk in zit.
Een scan die alleen naar techniek kijkt, laat een deel van het beeld buiten beschouwing. In de praktijk kijkt u naar vier gebieden die elkaar beïnvloeden.
Welke applicaties bevatten welke gegevens, en hoe komen die gegevens van A naar B? Let daarbij ook op koppelingen die niet in de systeemdocumentatie staan: handmatige exports, macro’s in spreadsheets, een script op de laptop van een collega. Zulke informele koppelingen verdienen aandacht als mogelijk risico: wie bewaakt ze, en wat gebeurt er als de maker vertrekt?
Wat betekent “klant”, “medewerker” of “afgehandelde aanvraag” precies, en betekent het in elk systeem hetzelfde? Verschillen in definities kunnen verklaren waarom rapportages niet met elkaar kloppen. Een scan legt die botsingen bloot en benoemt ze concreet.
Wie mag beslissen over de definitie van een veld, over toegang tot een bron, over het opschonen van historische data? Als het antwoord “dat weten we niet” of “iedereen een beetje” is, dan loopt u het risico dat technische verbeteringen weer weglekken. Een architectuur kan dit uittekenen, maar niet overnemen: iemand in uw organisatie moet het beleggen.
Wie houdt de koppelingen draaiend, wat gebeurt er als een export mislukt en hoe merkt u dat? Hoe zwaar rust het geheel op de kennis van individuen? Dit gebied krijgt gemakkelijk minder aandacht dan de techniek, terwijl het medebepalend is voor of uw datavoorziening op langere termijn blijft werken.
De grootste fout bij een scan is alleen met IT praten. IT kan u vertellen welke servers er staan en welke licenties lopen, maar heeft niet altijd zicht op welke cijfers een afdeling wekelijks handmatig corrigeert. Die kennis zit bij de mensen die met de cijfers werken.
Zorg dus dat u per belangrijk proces minstens één gebruiker spreekt: de controller, de teamleider van de klantenservice, de beleidsadviseur die de kwartaalcijfers maakt. Zij weten waar het schuurt, welke systemen ze omzeilen en welke definities in de praktijk anders worden gebruikt dan op papier staat.
Daarnaast hebt u iemand nodig die besluiten kan nemen en eigenaarschap kan beleggen. Zonder die persoon loopt u het risico dat de scan eindigt als een lijst met bevindingen waar niemand iets mee mag doen. Reserveer die rol vooraf, niet achteraf.
Een scan zoals hier beschreven levert geen opgeruimde data en geen werkende architectuur. Wat u wel krijgt, als het goed gebeurt en binnen de grenzen van de afgesproken scope, de beschikbare documentatie en de gesprekken die u kunt voeren:
Een kaart van uw datalandschap. Alle systemen, alle koppelingen inclusief de informele, en per koppeling wie ervoor verantwoordelijk is. Bestaat zo’n kaart in uw organisatie nog niet, dan is dit op zichzelf al een bruikbaar resultaat.
Een lijst van botsende definities. Concreet, met de systemen erbij en de gevolgen voor rapportages. Dit onderdeel maakt tastbaar waar afwijkende cijfers vandaan kunnen komen, en is daarmee een bruikbare basis voor het gesprek met het management.
Een risicobeeld. Waar hangt de continuïteit aan één persoon, welke koppeling breekt bij de eerstvolgende update, welke gegevens worden bewaard zonder dat iemand weet waarom. Gaat het om persoonsgegevens, dan zijn bewaardoel, bewaartermijn en wie verantwoordelijk is punten die u nader moet laten onderzoeken. Een architectuurscan is geen juridische toets en vervangt dat onderzoek niet.
Een prioritering. Niet alles hoeft tegelijk. Een goede scan benoemt een beperkt aantal zaken die u als eerste zou moeten aanpakken en waarom, en welke u bewust kunt laten liggen.
Een eerlijk antwoord op uw oorspronkelijke vraag. Kan dat AI-project starten? Soms is het antwoord ja. Soms is het: ja, maar eerst dit. En soms is het nee, nog niet. Dat laatste antwoord is vervelend, maar het is beter om dat vooraf te horen dan het halverwege een project zelf te ontdekken.
Een aantal patronen die wij regelmatig tegenkomen bij scans die weinig opleverden:
De scan duurt te lang. Een opname die maanden loopt, is een architectuurproject geworden. Spreek vooraf een duidelijke afbakening en een doorlooptijd van enkele weken af. Hoeveel weken hangt af van de omvang van uw landschap en hoe snel de juiste mensen beschikbaar zijn; wees kritisch op aanbiedingen die veel korter beloven en vraag wat er dan precies wordt bekeken.
De uitvoerder verkoopt ook het platform. Dan bestaat het risico dat de uitkomst wordt gekleurd door dat belang. Laat de scan uitvoeren door een partij die geen belang heeft bij een specifieke tool, of leg vooraf vast dat productadvies buiten de scope valt.
Alleen documentatie wordt bekeken. Wat op papier staat, kan afwijken van de praktijk. Een scan zonder gesprekken met gebruikers levert een beeld op van hoe het bedoeld was, niet van hoe het werkt.
Het rapport verdwijnt in de la. Dat risico is groter als er niemand is die met de uitkomsten mag handelen. Koppel de scan vooraf aan een besluitmoment: op datum X bespreken we de bevindingen en besluiten we over de eerste drie acties.
De scan wordt een schuldvraag. Bevindingen over botsende definities of ongedocumenteerde koppelingen zijn geen verwijt aan de mensen die het landschap jarenlang draaiend hielden. Communiceer dat vooraf, anders loopt u het risico dat juist de mensen met de meeste kennis terughoudend worden.
U hoeft niet met een volledige scan te beginnen. Begin met een eenvoudige vraag: schrijf drie rapportages of cijfers op die u niet volledig vertrouwt, en zoek per rapportage uit welke systemen erachter zitten en wie de definitie bepaalt. Dit is een indicatieve oefening, geen meting. Lukt het vlot, dan is dat een eerste aanwijzing dat uw basis redelijk staat. Kost het veel moeite of loopt u vast, dan is dat een signaal dat een bredere opname zinvol kan zijn.
Wilt u een snellere eerste indruk, dan heeft Twentynext een online zelfscan: zestien vragen, zeven minuten, en u ziet direct een spinnenweb met uw sterkste en zwakste dimensie. U hoeft daarvoor geen e-mailadres op te geven. Het vervangt geen echte opname. Wel kunt u het gebruiken als gespreksopening voor het volgende overleg met IT en de proceseigenaren.
Zo maken we dit. AI schrijft de eerste versie, een tweede AI controleert, en een mens van Twentynext leest en keurt elk artikel goed voordat het live gaat. We controleren feiten en bronnen zorgvuldig, maar kunnen juistheid en volledigheid niet garanderen. Zie onze disclaimer.
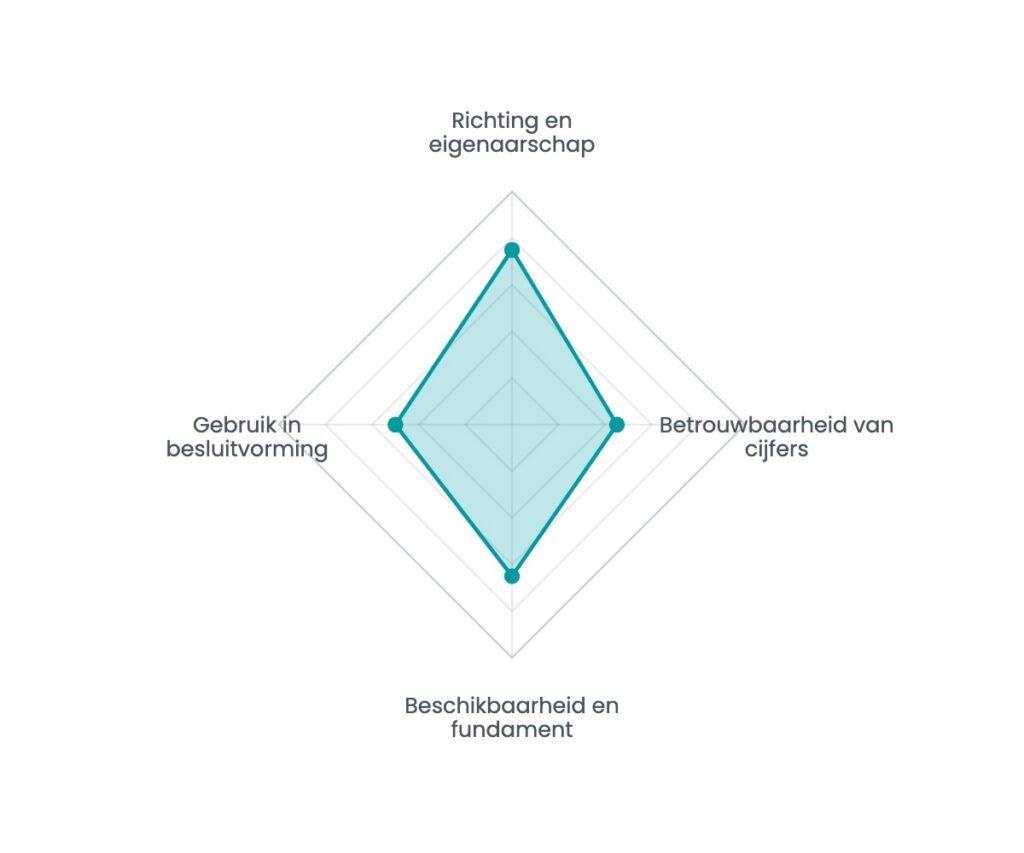
Zestien vragen, zeven minuten, direct een spinnenweb met uw sterkste en zwakste dimensie. Geen e-mailadres nodig om het resultaat te zien.
AI · Blogs · 20 oktober 2026
Het kan gebeuren dat een model dat in de testomgeving goed presteert, in de uitvoering minder oplevert dan verwacht.
Lees het artikel →
AI · Blogs · 16 oktober 2026
Sinds 2 februari 2025 is AI-geletterdheid een wettelijke verplichting uit de Europese AI-verordening.
Lees het artikel →
AI · Blogs · 14 oktober 2026
Een gedeelde, onjuiste aanname stuurde honderden AI-agents richting Hugging Face. Wat dat incident leert over bevoegdheden, herkomst en veilig stoppen.
Lees het artikel →
Samenwerken
De mensen die het bouwen, beheren het daarna. Sinds 2014 in Eindhoven.
Wij gebruiken Google Tag Manager om bezoek te meten en Leadinfo om te herkennen welk bedrijf onze site bezoekt. Beide laden alleen als u daarmee instemt. Kiest u voor alleen noodzakelijk, dan werkt de site gewoon en meten wij niets. Cookieverklaring · Privacyverklaring
